让首帧把信息交代清楚
只裁面部会让模型缺少吃东西的信息。W Chews AI 首帧应显示头肩、手和食物,使用自己的照片或原创虚构成人。食物照片单独存在时,先把人物与食物合成同一首帧;此模式第二张上传图是末帧。
你的照片、你的食物、你的评价。编辑提示词制作美食反应片段,再自己加上准确字幕。
W Chews AI 是美食反应视频工作流:让照片中的人物咬一口、面无表情地停顿,再给出成功或失望的反应。
W Chews 表示好吃,L Nibbles 表示失望。Vogoo 提供可编辑的场景提示词;准确的评价字幕请在剪辑软件里添加。
W Chews AI 的场景越简单越容易读懂:食物、面孔和反应清晰可见,不依赖对白。
只裁面部会让模型缺少吃东西的信息。W Chews AI 首帧应显示头肩、手和食物,使用自己的照片或原创虚构成人。食物照片单独存在时,先把人物与食物合成同一首帧;此模式第二张上传图是末帧。
开心的笑容与失望的凝视表达不同笑点。W Chews AI 提供可编辑的美食反应提示词,而非锁定的表演。选择创意后替换食物和表情;轻轻点头往往比完整舞蹈更易表现。先咬一口,再反应。
生成时嘴部、手与食物接触可能发生变化。W Chews AI 可按小口咬、放低食物、停顿、反应的顺序描述。固定机位和背景更便于检查。把输出当草稿,查看手指、嘴部和剩余食物,动作不清楚时再调整。
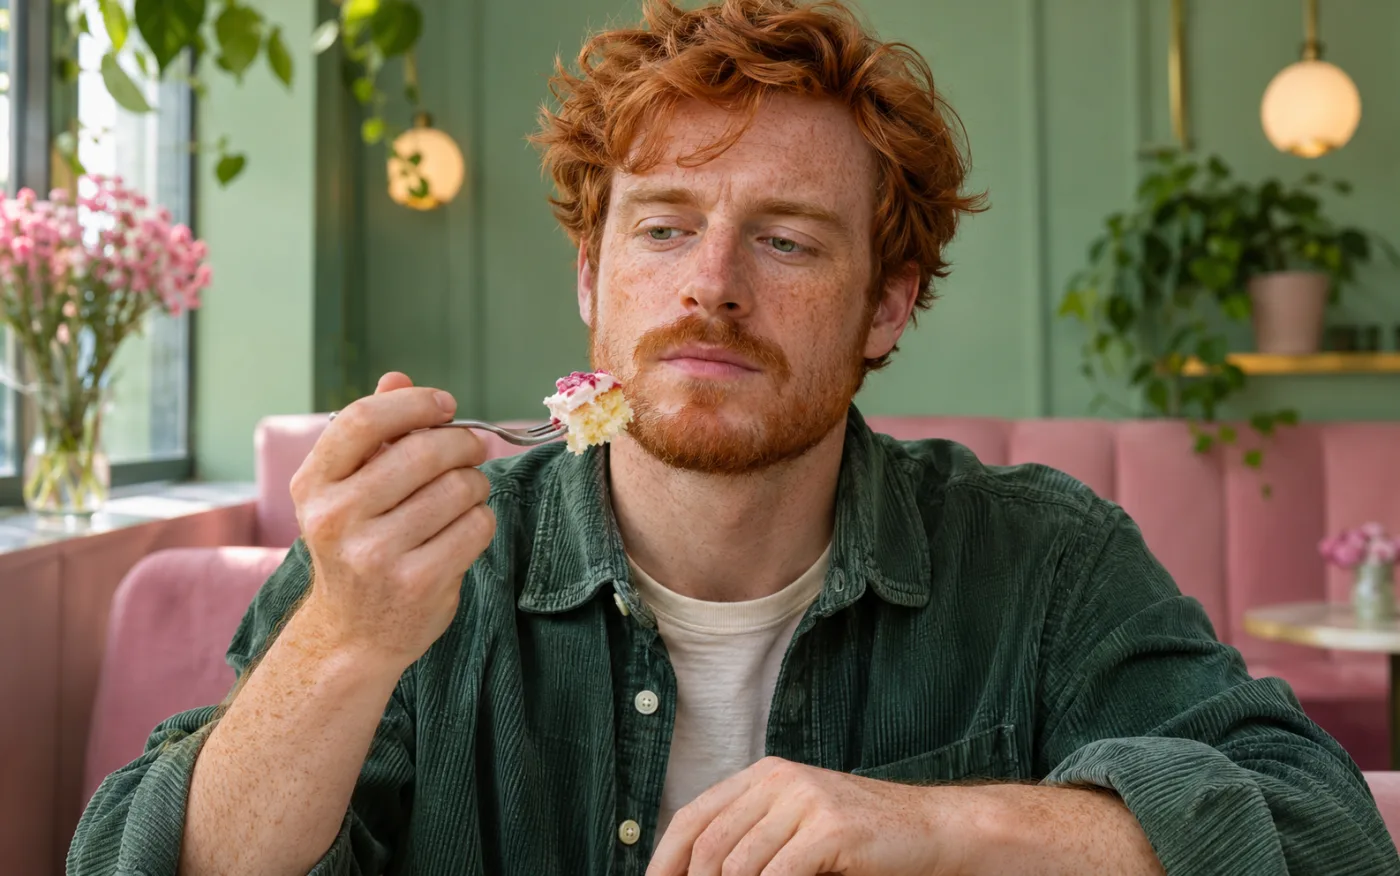
W Chews AI 负责动态场景,准确文字在后期添加。把 W Chews 或 L Nibbles 放在反应后出现,避开面部,确保手机可读。可选生成音频能添加环境气氛,但不是原梗音轨;发布时单独选择有使用权限的音乐。
按自己的食物和表情修改 W Chews AI 创意。提示词只是动作指导,不保证精确复现。
说明上传首帧中的人物与手中食物。W Chews AI 需要清楚的食物移动路径,中景构图能让咬一口的动作留在画面内。
小口咬、放下食物、停顿、反应。W Chews AI 的成功评价可用微笑和点头;L Nibbles 可用轻轻摇头或失望的一瞥。
要求面孔、衣服、房间与光线保持一致,镜头固定。W Chews AI 仍可能改变身份和食物形状,需要检查整段视频。
画面上方保持简洁,面孔清晰。W Chews AI 的评价在停顿之后加入,自己准确输入文字,不依赖模型生成拼写正确的动画字。
这些是 W Chews AI 创作方向,并非真实食评,也不承诺食物的口味。
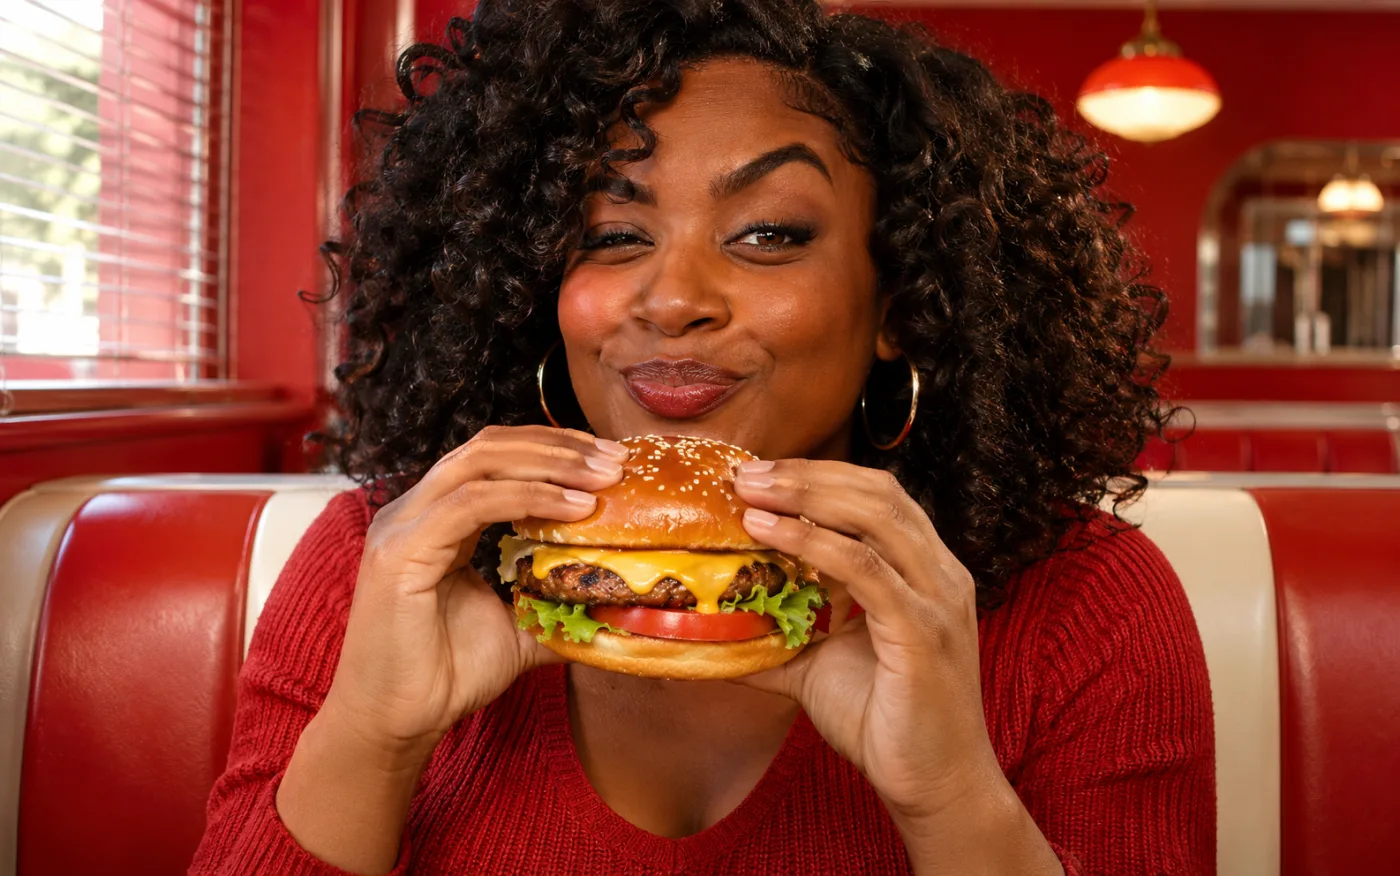
把日常外卖变成一本正经的试吃。W Chews AI 可用清楚可见的汉堡与克制的点头制造反差。
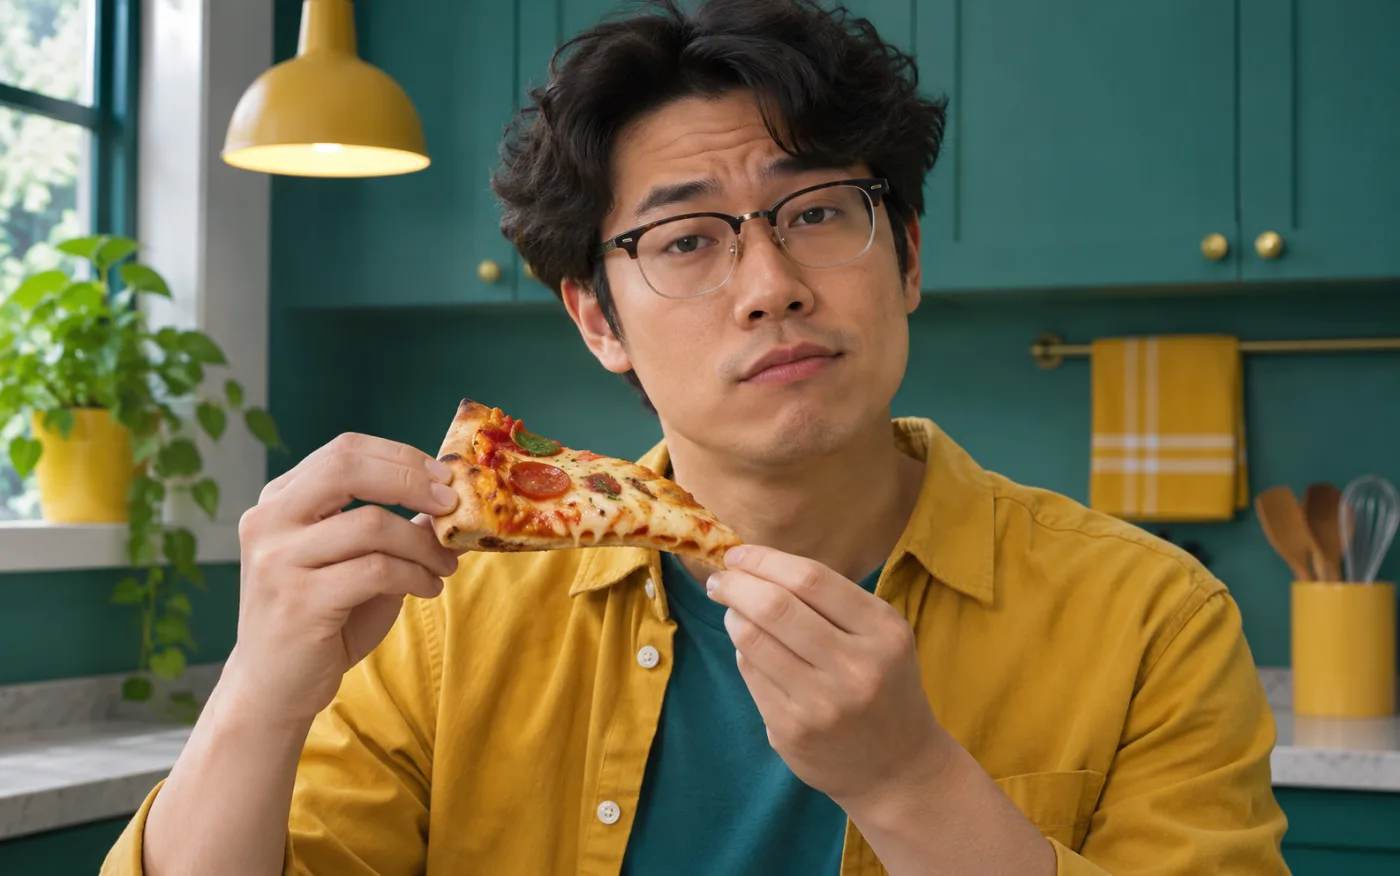
昨天的披萨配上认真的停顿。W Chews AI 用怀疑的眉毛表现 L Nibbles,再后期添加字幕,保持轻松玩笑。
吃一小口自己做的蛋糕后认真点头。W Chews AI 可以用你自己的肖像,为朋友群制作美食反应创意。
原创角色不需要借用他人的身份。准备带食物的虚构成人首帧,再用 W Chews AI 描述动作,发布时标注 AI 制作。
为不同零食分别做玩笑短片。W Chews AI 是创意工作流,由你决定评价;它不会真实品尝、检测或客观评分。
不说话也能表现美食反应。W Chews AI 用停顿和表情讲笑点,后期加 L Nibbles 或 W Chews,环境音按需开启。
准备首帧、编辑动作、最后加字幕。生成消耗工作台按钮显示的积分。
步骤 01
选择自己或已授权成人的清晰照片,画面包含食物。W Chews AI 竖屏首帧先裁成 9:16,嘴部和手不被遮挡,避免多人合照。
步骤 02
载入创意并修改食物、停顿和最终表情。默认是 Seedance 2.5 图生视频,可选时长、分辨率与音频,准备好后查看按钮积分再生成。
步骤 03
检查咬食物、面孔连续、手部和声音。下载成功的 W Chews AI 片段,再在剪辑软件添加准确评价字幕;只使用有发布权限的音乐。
下表为 Vogoo 中 Seedance 2.5 图生视频的设置。切换模型后,以实际面板选项为准。
| 设置 | 支持范围 | 说明 |
|---|---|---|
| 输入 | 照片作为首帧 | 人物和食物放在同一图里,第二张可选图作为末帧。 |
| 时长 | 4–15 秒 | 在工作台选择时长,为停顿和反应留足时间。 |
| 分辨率 | 480p / 720p / 1080p | 费用随模型和设置变化,以显示值为准。 |
| 竖屏 | 使用 9:16 首帧 | 默认适配器跟随输入图片的比例。 |
| 声音 | 可选生成音频 | 检查输出,不提供原梗音乐。 |
| 评价文字 | 剪辑软件后期添加 | 不保证视频模型准确生成动画字。 |
可以,用自己或已授权成人的照片进入图生视频。W Chews AI 首帧最好是能看见手和食物的较宽肖像,而不是只裁面部。输出可能仍需调整或后期剪辑。
L Nibbles 是食物让人失望的评价,W Chews 则表示好吃。在 W Chews AI 中,你通过提示词和字幕选择反应。这是虚构表演,不是营养评估或真实试吃。
准确字幕请在剪辑软件里添加。W Chews AI 提示词可以请求文字,但模型可能拼写或位置出错。先生成清晰反应,再添加不会挡住脸和食物的 W Chews 或 L Nibbles。
默认图生视频中的额外图片是末帧,不是独立食物参考。W Chews AI 应先准备合成首帧;需要多参考图时可了解单独的 Reference to Video 工具及模型设置。
生成视频消耗积分,打开页面和编辑提示词不会生成视频。W Chews AI 不保证免费成片,当前注册赠送积分不足以覆盖视频最低费用,请查看生成按钮和价格页。
可以,默认模型按源图适配,先准备 9:16 首帧,再按需开启生成音频。W Chews AI 可请求环境声或进食声,但发布前需要试听;生成声音不是原梗音轨或授权音乐。
生成动作可能改变面孔、手指和食物接触。简化 W Chews AI 提示词,使用光线清晰的首帧和固定镜头,要求小口咬、短反应。身份连续与自然咀嚼是目标,不是保证。
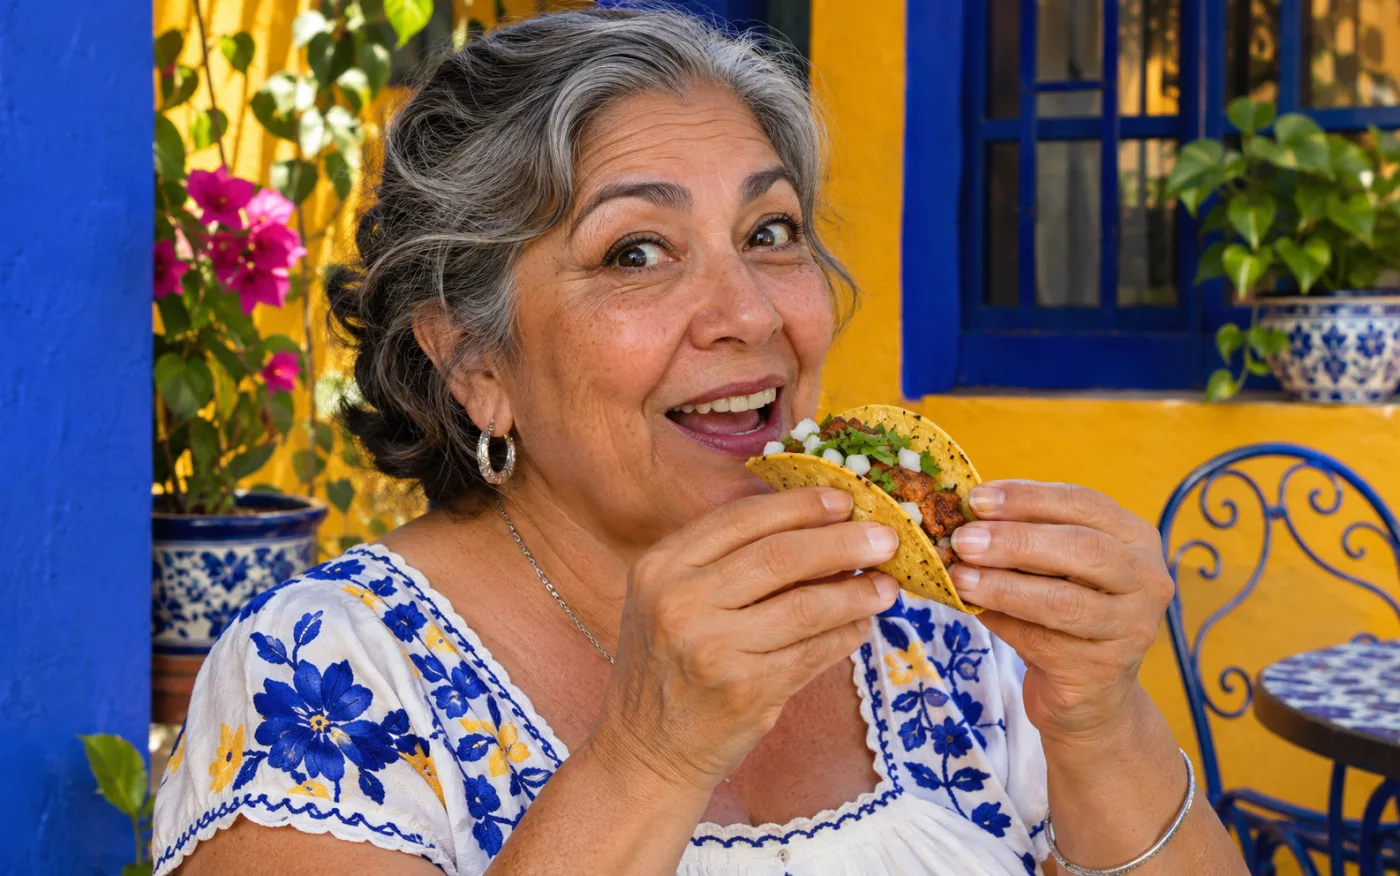
这里是原创 AI 概念静帧,人物为虚构成人,并非 Vogoo 导出的视频。它们展示美食反应方向并载入可编辑提示词;图片用于说明构图和表情,不代表视频模型已成功复现动作。