01
逐帧精确的动作迁移
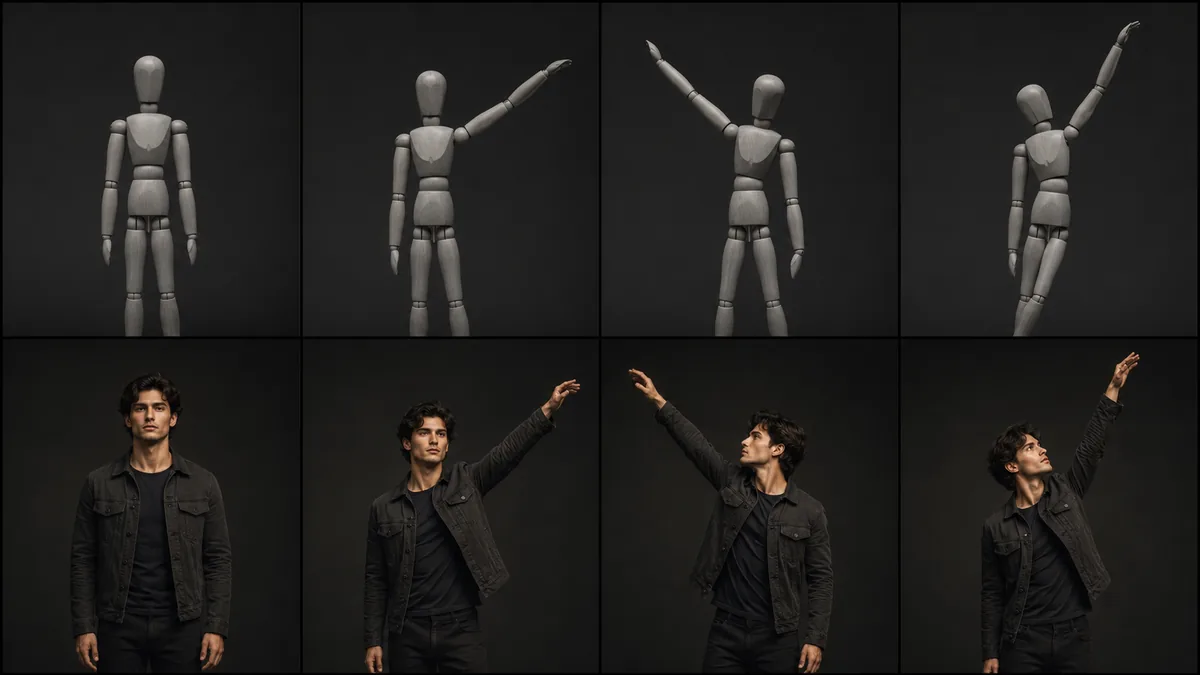
模型逐帧读取参考视频,把转头、肩部转动、手臂轨迹和上身倾斜映射到角色图片上。节奏被完整保留,源视频第 4 秒的动作落点,在结果里仍然是第 4 秒。Motion Control AI 不会把这段表演重采样成千篇一律的通用动作。
Motion Control AI 把参考视频中的动作迁移到静态角色图片上,一张肖像就能跳舞、做手势、出镜讲解,不需要绑定骨骼,也不需要打关键帧。上传角色图片和一段 3 到 30 秒的参考视频,Motion Control AI 视频会基于 Kling 2.6 或 Kling 3.0 以 720p 或 1080p 渲染。
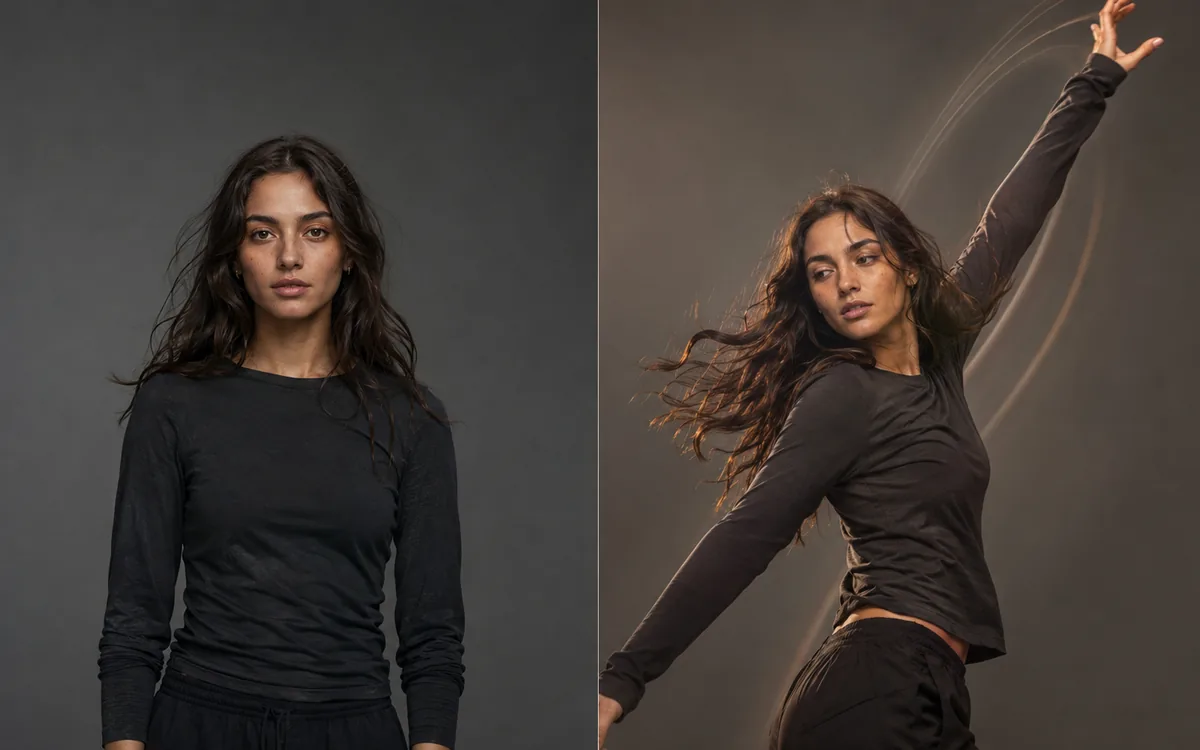
Motion Control AI 是一个视频到视频的模型:它从一段片段里读出人体动作,再让你图片里的角色重新演一遍,同时保持这个角色本身不变。
Motion Control AI 把“表演”和“表演者”拆开。参考视频提供节奏、身体角度和手势,角色图片提供脸、服装和身形比例,渲染出的是同一段表演由你的角色完成的新片段。
两个文件。一张头部、肩膀和上半身清晰可见、短边不低于 340 像素的角色图片,以及一段 3 到 30 秒、同样露出上半身的参考视频。Motion Control AI 里的文字提示词是可选项。
提示词驱动的动画是凭描述“编”出动作,每次跑都会漂移。Motion Control AI 是逐帧复制你已经选定的动作,所以舞蹈编排、手语和产品演示动作在迁移后依然完整。
Motion Control AI 视频流程替你处理的五件事,从动作提取一直到最终渲染。
模型逐帧读取参考视频,把转头、肩部转动、手臂轨迹和上身倾斜映射到角色图片上。节奏被完整保留,源视频第 4 秒的动作落点,在结果里仍然是第 4 秒。Motion Control AI 不会把这段表演重采样成千篇一律的通用动作。
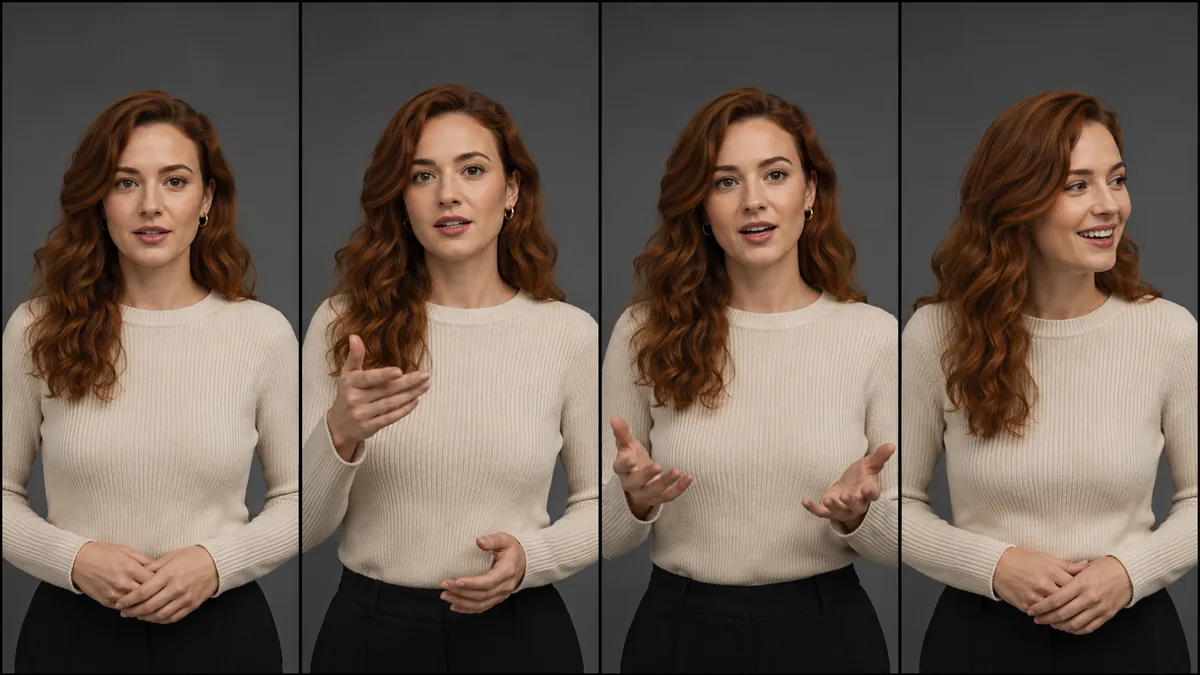
脸、发型、服装和身形比例全部来自你的静态角色图片,并在整段片段里保持锁定。因为 AI motion control 这一步不会用提示词重新生成角色,第 1 秒出现的人和第 20 秒出现的人是同一个。Motion Control AI 让角色始终可辨认。
Motion Control AI 提供四个预设:Kling 2.6 的 720p 与 1080p,Kling 3.0 的 720p 与 1080p。Kling 2.6 出片更快、消耗额度更少;Kling 3.0 在快速肢体动作、部分遮挡和密集编舞上变形更少。在上方模型选择器里切换即可。
没有固定 5 秒上限。渲染出的片段与参考视频等长,3 到 30 秒都可以,计费按分辨率和时长累加。用 Motion Control AI 跑一条长镜头,胜过拼接四段接缝对不上的生成结果。
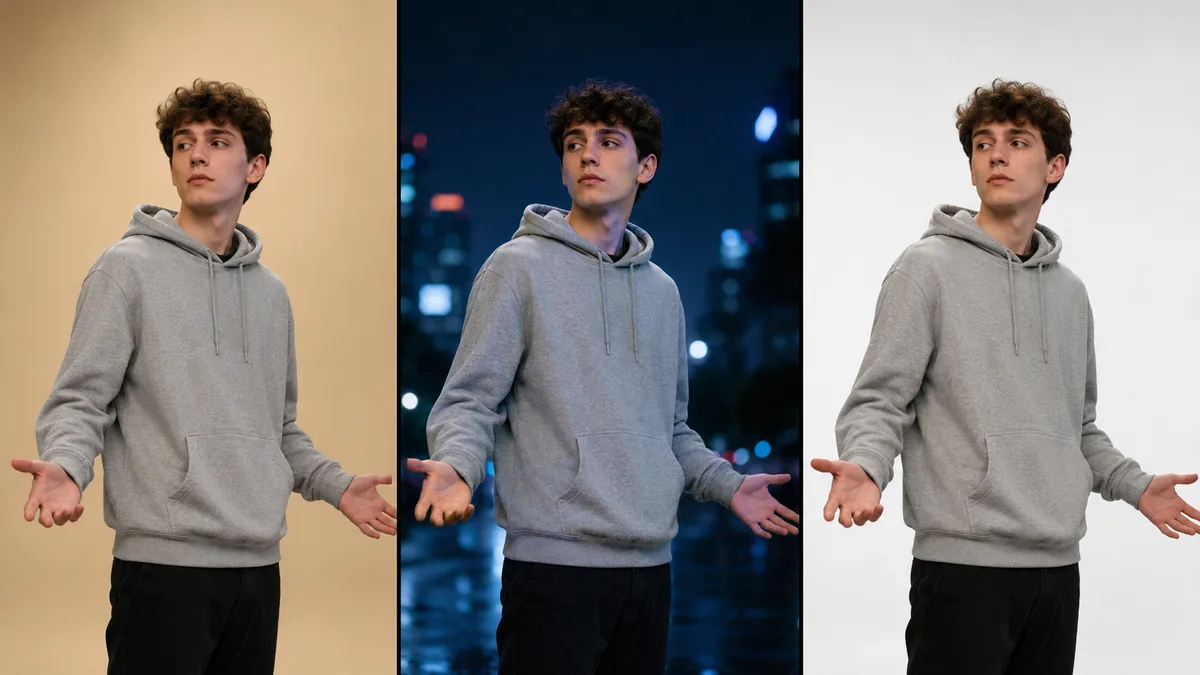
不填提示词时,Motion Control AI 完全按参考视频执行。补一句关于光线、背景或情绪的描述,画面会朝那个方向偏移,动作本身不受影响。这是把同一段动作复用成多种视觉风格最快的做法。
两个上传文件必须展示同一块上半身区域。以下是 Motion Control AI 在开始渲染前会检查的限制。
| 输入项 | 要求 | 说明 |
|---|---|---|
| 角色图片 | PNG / JPEG,不超过 5 MB,短边 ≥ 340px | 头部、肩膀与上半身清晰可见 |
| 参考视频 | MP4 / MOV,不超过 100 MB | 3 到 30 秒,画面里只有一位表演者 |
| 连续动作 | 至少 3 秒 | 硬切和静帧会削弱动作追踪 |
| 上半身取景 | 两个文件都必须满足 | 只拍手部或过远的全景会匹配失败 |
| 输出分辨率 | 720p 或 1080p | 与模型分开选择,按秒计费 |
| 输出音频 | 无音频选项 | 模型不会自己配任何声音 |
额度随分辨率和时长增加,所以先用 720p 试一遍动作,再决定要不要跑 1080p 的 Motion Control AI 视频,是最省的做法。
四个习惯,决定一次 Motion Control AI 渲染看起来是被导演过的,还是糊成一团。
挑一段和角色图片取景方式接近的参考视频。用半身肖像配全身舞蹈片段,模型只能凭空补出它没见过的腿。取景对齐是这里最有效的单一质量杠杆。
参考视频里出现两个人会让动作信号被拆分。把片段裁到只有一位表演者清晰可见的那一段,AI motion control 才有明确的追踪对象。
干净利落的手势比运动模糊、硬切和大面积遮挡更容易迁移。源视频里肢体被家具挡住的部分,输出时大概率会糊。
第一遍用便宜的方式跑。等取景、角色一致性和节奏都对了,再把同一组素材用 Motion Control AI 以 1080p 重跑一次作为成片。
六个“复制真实表演比描述表演更划算”的场景,AI motion control 在这些场景里省掉了一整个动画环节。
把一条实拍素材复用到一整组 AI 角色上,虚拟创作者不用重新开拍也能日更。Motion Control AI 让多次上传之间的脸和服装保持稳定。
只录一遍动作,再换角色、换服装、换场景重新演绎,供 TikTok、Reels 和 Shorts 使用。免费的 motion control AI 跑一遍 720p,发社交平台足够了。
让出镜者按你实拍的手部轨迹拿起、打开、演示某样东西,而不是靠文字提示词赌第十次终于做对了这个动作。
先用自己出镜的参考视频把镜头排出来,再换成角色设定图。动画师用 Motion Control AI 在正式绑骨之前验证节奏。
把一条已过审的表演分别套到多张角色图片上,产出不同地区版本,不必重新约演员,也不用重做剪辑。
在含义取决于精确动作的场景里保住手型和节奏。Motion Control AI 是复制源动作而不是猜,而提示词驱动的视频模型经常把这类动作做废。
没有时间线、没有骨骼、没有关键帧。Motion Control AI 只需要两个文件和一次点击。
步骤 01
选一张头部、肩膀和上半身清晰可见的照片或生成肖像,短边至少 340 像素。画面里只有一个人、光线均匀、不要裁得太紧。
步骤 02
放入一段 3 到 30 秒、包含你想复制的表演的片段。同样要露出上半身,并且至少有三秒连续动作。
步骤 03
在 Kling 2.6 与 Kling 3.0 的 720p 或 1080p 之间选择,按需补一句提示词,然后启动 Motion Control AI 渲染,完成后下载成片。
第一次做 Motion Control AI 视频之前,大家最常问的问题。
Kling 3.0 在快速肢体动作、部分遮挡和密集编舞上的瑕疵更少,每秒消耗的额度也更高。Kling 2.6 更快更便宜,对平稳的上半身动作、讲话手势和简单舞蹈通常已经够用。
3 到 30 秒之间,文件不超过 100 MB。更短的片段无法提供足够的连续动作让模型锁定,更长的素材需要先剪好再上传。渲染出的 motion control 视频与参考视频等长。
Motion Control AI 两个方向都没有音频开关:Kling 的 motion-control 接口不接受任何声音参数,所以既不会自己生成,也不做任何保证。以实际渲染结果为准;如果缺你要的声轨,在剪辑软件里把原声放回去即可——节奏与参考视频一致,是对得上的。
不带。输出画面上不会烧任何标记,下载到的就是可以直接发布的版本。
付费套餐包含生成内容的商用授权。但两个输入文件的权利仍由你负责:不要上传没有授权的真人素材或受版权保护的表演。Motion Control AI 不会替你清理这些权利。
不涉及绑骨、关键帧或动作捕捉设备。整个流程就是两次上传加一次模型选择,所以想拿到最好的 AI motion control 结果,关键通常在于挑一段合适的参考视频,而不是技术功底。
上半身表演:手势、转头、舞蹈、讲解和手语。全身杂技、大幅镜头运动,以及主体出画的镜头,对任何 AI motion control 模型来说都是最难的情况。
嘴部动作会随脸部一起被复制,但它不是对口型工具。如果需要用音频文件驱动说话,请改用专门的 AI Lip Sync 页面。
先生成一段。用文生视频做一小段人物动作片段就能当作动作来源,再把它和你真正想出镜的角色图片一起送进 Motion Control AI。
上传一张角色图片和一段参考视频,选好 720p 或 1080p,剩下的动画工作交给 Motion Control AI。免费额度已经准备好了。